Domain datajunkie.de kaufen?
Wir ziehen mit dem Projekt
datajunkie.de um.
Sind Sie am Kauf der Domain
datajunkie.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain datajunkie.de kaufen?
Wie beeinflusst die Datenkonsistenz die Leistung von verteilten Systemen in Bezug auf Datenbanken, Cloud-Computing und Big Data-Anwendungen?
Die Datenkonsistenz beeinflusst die Leistung von verteilten Systemen, da inkonsistente Daten zu Fehlern und Inkonsistenzen in den Anwendungen führen können. In Datenbanken kann eine schlechte Datenkonsistenz zu langsamen Abfragen und ineffizienten Transaktionen führen. Im Cloud-Computing können inkonsistente Daten zu Problemen bei der Skalierbarkeit und Zuverlässigkeit führen. In Big Data-Anwendungen kann eine inkonsistente Datenkonsistenz zu ungenauen Analysen und Entscheidungen führen, die die Leistung der Anwendung beeinträchtigen. **
Wie beeinflusst die Datenkonsistenz die Leistung von verteilten Systemen und wie kann sie in verschiedenen Bereichen wie Datenbanken, Cloud-Computing und Big Data-Verarbeitung gewährleistet werden?
Die Datenkonsistenz beeinflusst die Leistung von verteilten Systemen, da inkonsistente Daten zu Fehlern und Inkonsistenzen in den Ergebnissen führen können. In Datenbanken kann die Datenkonsistenz durch Transaktionsmechanismen wie ACID (Atomicity, Consistency, Isolation, Durability) gewährleistet werden. Im Cloud-Computing können konsistente Daten durch die Verwendung von verteilten Datenbanken und Replikationstechniken sichergestellt werden. In der Big Data-Verarbeitung kann die Datenkonsistenz durch die Verwendung von verteilten Dateisystemen und Datenreplikation erreicht werden, um sicherzustellen, dass alle Knoten im System auf konsistente Daten zugreifen. **


Ähnliche Suchbegriffe für Guess-Sonnenbrille-GF5082-52F
Top-Angebote
Produkte zum Begriff Guess-Sonnenbrille-GF5082-52F:


-
Wie kann die Gruppierung von Daten in der Informatik zur effizienten Verarbeitung und Analyse in verschiedenen Anwendungen wie Datenbanken, maschinellem Lernen und Big Data verwendet werden?
Die Gruppierung von Daten in der Informatik ermöglicht es, ähnliche Datenobjekte zusammenzufassen, was die Effizienz bei der Verarbeitung und Analyse erhöht. In Datenbanken können gruppierte Daten schneller abgefragt und analysiert werden, was die Leistung verbessert. Im maschinellen Lernen können gruppierte Daten dazu beitragen, Muster und Trends zu identifizieren, die für die Modellbildung und Vorhersage wichtig sind. In Big Data-Anwendungen ermöglicht die Gruppierung von Daten eine schnellere Verarbeitung großer Datenmengen und erleichtert die Extraktion von relevanten Informationen. **
-
Was sind die verschiedenen Methoden zur Bereinigung von Daten in der Informatik, und wie werden sie in verschiedenen Anwendungsgebieten wie Datenbanken, maschinellem Lernen und Big Data eingesetzt?
In der Informatik gibt es verschiedene Methoden zur Bereinigung von Daten, darunter das Entfernen von Duplikaten, das Auffüllen fehlender Werte, das Korrigieren von Tippfehlern und das Normalisieren von Datenformaten. In Datenbanken werden Bereinigungsmethoden verwendet, um die Qualität und Konsistenz der gespeicherten Daten zu verbessern, was wiederum die Genauigkeit von Abfragen und Analysen erhöht. Im maschinellen Lernen werden Bereinigungstechniken eingesetzt, um rauschige oder inkonsistente Daten zu entfernen, was die Leistung von Modellen verbessert und Overfitting verhindert. Im Bereich Big Data werden Bereinigungsmethoden eingesetzt, um große Mengen von unstrukturierten Daten zu organisieren und zu bereinigen, um wertvolle Erken **
-
Wie beeinflusst die Verwendung von Suchindizes die Effizienz von Datenbankabfragen in der Informatik und wie werden sie in verschiedenen Anwendungen wie Suchmaschinen, Datenbanken und Big Data-Analysen eingesetzt?
Die Verwendung von Suchindizes verbessert die Effizienz von Datenbankabfragen, da sie es ermöglichen, schnell auf die gespeicherten Daten zuzugreifen, ohne die gesamte Datenbank durchsuchen zu müssen. In Suchmaschinen werden Suchindizes verwendet, um die relevantesten Ergebnisse für eine Suchanfrage zu liefern, indem sie die relevanten Informationen aus dem gesamten Web indexieren. In Datenbanken ermöglichen Suchindizes eine schnelle Suche und Abfrage von Daten, was die Leistung und Effizienz der Datenbank verbessert. In Big Data-Analysen werden Suchindizes verwendet, um große Datenmengen effizient zu durchsuchen und relevante Informationen für die Analyse zu extrahieren. **
-
Wie beeinflusst die Verwendung von Suchindizes die Leistung von Datenbankabfragen in der Informatik und wie werden sie in verschiedenen Anwendungen wie Suchmaschinen, Datenbanken und Big-Data-Analysen eingesetzt?
Die Verwendung von Suchindizes verbessert die Leistung von Datenbankabfragen, indem sie den Zugriff auf die gespeicherten Daten beschleunigen. Sie ermöglichen es, die relevanten Datensätze schneller zu finden und abzurufen, was die Antwortzeiten bei Abfragen verkürzt. In Suchmaschinen werden Suchindizes verwendet, um die Suchergebnisse effizient zu liefern, während sie in Datenbanken die Abfragegeschwindigkeit verbessern. In Big-Data-Analysen werden Suchindizes eingesetzt, um große Datenmengen effizient zu durchsuchen und relevante Informationen zu extrahieren, was die Analyseprozesse beschleunigt. **


Wie beeinflusst die Verwendung von Suchindizes die Effizienz von Datenbankabfragen in der Informatik und wie werden sie in verschiedenen Anwendungen wie Suchmaschinen, Datenbanken und Big-Data-Analysen eingesetzt?
Die Verwendung von Suchindizes verbessert die Effizienz von Datenbankabfragen, da sie es ermöglichen, schnell auf relevante Daten zuzugreifen, ohne die gesamte Datenbank durchsuchen zu müssen. In Suchmaschinen werden Suchindizes verwendet, um die Suchergebnisse schnell und genau zu liefern, indem sie relevante Webseiten vorab indizieren. In Datenbanken ermöglichen Suchindizes eine schnellere Abfrageverarbeitung, indem sie den Zugriff auf bestimmte Datensätze beschleunigen. Bei Big-Data-Analysen helfen Suchindizes, große Datenmengen effizient zu durchsuchen und relevante Informationen für die Analyse zu extrahieren. **
Wie beeinflusst das Splitten von Daten in der Informatik die Effizienz von Algorithmen und die Verarbeitung großer Datenmengen in verschiedenen Anwendungen wie Datenbanken, maschinellem Lernen und Big Data-Analysen?
Das Splitten von Daten in der Informatik ermöglicht es, große Datenmengen in kleinere Teile aufzuteilen, was die Effizienz von Algorithmen verbessert, da sie nur auf einem Teil der Daten arbeiten müssen. Dies führt zu schnelleren Verarbeitungszeiten und reduziert den Speicherbedarf. In Anwendungen wie Datenbanken ermöglicht das Splitten von Daten die parallele Verarbeitung, was die Leistung verbessert. Im maschinellen Lernen ermöglicht das Splitten von Daten das Training von Modellen auf Teilmengen, was die Skalierbarkeit verbessert. In Big Data-Analysen ermöglicht das Splitten von Daten die gleichzeitige Verarbeitung großer Datenmengen, was die Effizienz und Geschwindigkeit der Analyse erhöht. **
Top-Angebote
Produkte zum Begriff Guess-Sonnenbrille-GF5082-52F:
-
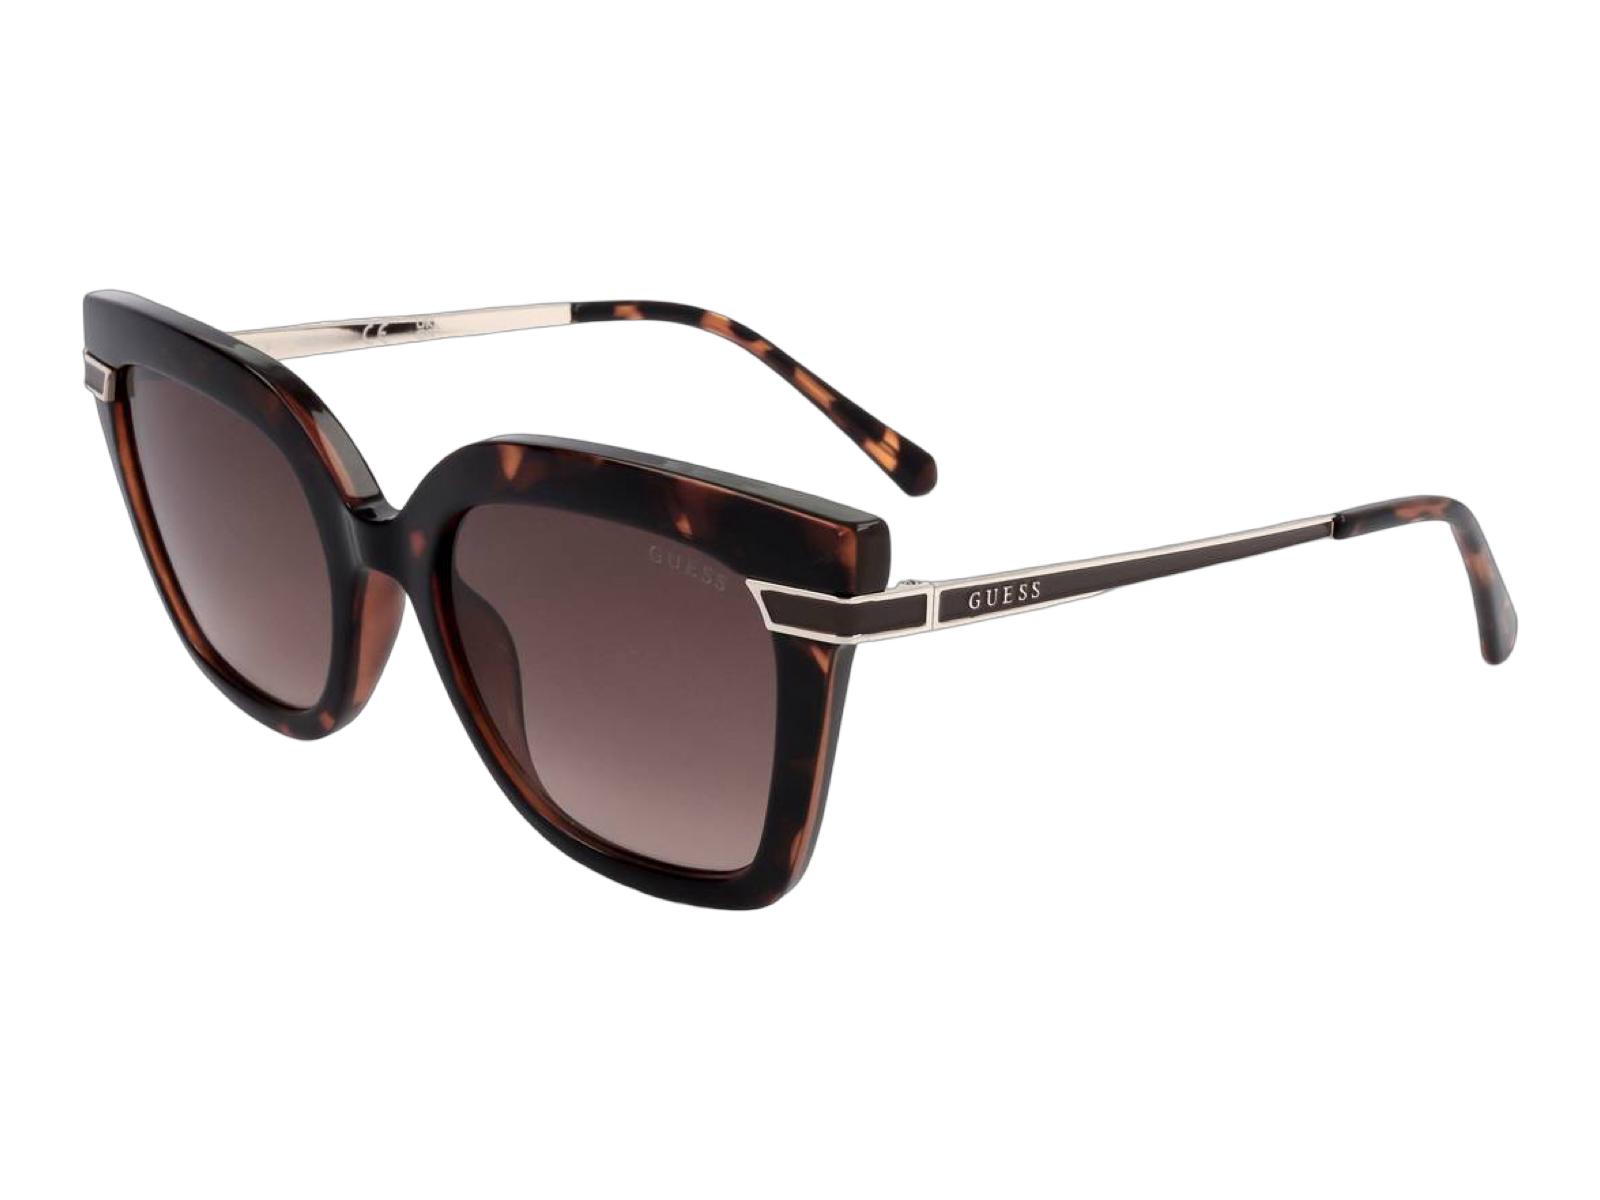
Guess Sonnenbrille GF5082 52F Braun Braun VerlaufDie Guess GF5082 52F Sonnenbrille in braunem Farbton hat einen klassischen quadratischen Rahmen, der zeitlose Eleganz ausstrahlt. Das Gestell ist aus hochwertigem Acetat gefertigt, das für seine Haltbarkeit und Leichtigkeit bekannt ist und den ganzen Tag lang einen hohen Tragekomfort bietet. Das Guess-Logo auf den schmalen Bügeln verleiht der Brille einen Hauch von Raffinesse.55,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie beeinflusst die Datenkonsistenz die Leistung von verteilten Systemen in Bezug auf Datenbanken, Cloud-Computing und Big Data-Anwendungen?
Die Datenkonsistenz beeinflusst die Leistung von verteilten Systemen, da inkonsistente Daten zu Fehlern und Inkonsistenzen in den Anwendungen führen können. In Datenbanken kann eine schlechte Datenkonsistenz zu langsamen Abfragen und ineffizienten Transaktionen führen. Im Cloud-Computing können inkonsistente Daten zu Problemen bei der Skalierbarkeit und Zuverlässigkeit führen. In Big Data-Anwendungen kann eine inkonsistente Datenkonsistenz zu ungenauen Analysen und Entscheidungen führen, die die Leistung der Anwendung beeinträchtigen. **
-
Wie beeinflusst die Datenkonsistenz die Leistung von verteilten Systemen und wie kann sie in verschiedenen Bereichen wie Datenbanken, Cloud-Computing und Big Data-Verarbeitung gewährleistet werden?
Die Datenkonsistenz beeinflusst die Leistung von verteilten Systemen, da inkonsistente Daten zu Fehlern und Inkonsistenzen in den Ergebnissen führen können. In Datenbanken kann die Datenkonsistenz durch Transaktionsmechanismen wie ACID (Atomicity, Consistency, Isolation, Durability) gewährleistet werden. Im Cloud-Computing können konsistente Daten durch die Verwendung von verteilten Datenbanken und Replikationstechniken sichergestellt werden. In der Big Data-Verarbeitung kann die Datenkonsistenz durch die Verwendung von verteilten Dateisystemen und Datenreplikation erreicht werden, um sicherzustellen, dass alle Knoten im System auf konsistente Daten zugreifen. **
-
Wie kann die Gruppierung von Daten in der Informatik zur effizienten Verarbeitung und Analyse in verschiedenen Anwendungen wie Datenbanken, maschinellem Lernen und Big Data verwendet werden?
Die Gruppierung von Daten in der Informatik ermöglicht es, ähnliche Datenobjekte zusammenzufassen, was die Effizienz bei der Verarbeitung und Analyse erhöht. In Datenbanken können gruppierte Daten schneller abgefragt und analysiert werden, was die Leistung verbessert. Im maschinellen Lernen können gruppierte Daten dazu beitragen, Muster und Trends zu identifizieren, die für die Modellbildung und Vorhersage wichtig sind. In Big Data-Anwendungen ermöglicht die Gruppierung von Daten eine schnellere Verarbeitung großer Datenmengen und erleichtert die Extraktion von relevanten Informationen. **
-
Was sind die verschiedenen Methoden zur Bereinigung von Daten in der Informatik, und wie werden sie in verschiedenen Anwendungsgebieten wie Datenbanken, maschinellem Lernen und Big Data eingesetzt?
In der Informatik gibt es verschiedene Methoden zur Bereinigung von Daten, darunter das Entfernen von Duplikaten, das Auffüllen fehlender Werte, das Korrigieren von Tippfehlern und das Normalisieren von Datenformaten. In Datenbanken werden Bereinigungsmethoden verwendet, um die Qualität und Konsistenz der gespeicherten Daten zu verbessern, was wiederum die Genauigkeit von Abfragen und Analysen erhöht. Im maschinellen Lernen werden Bereinigungstechniken eingesetzt, um rauschige oder inkonsistente Daten zu entfernen, was die Leistung von Modellen verbessert und Overfitting verhindert. Im Bereich Big Data werden Bereinigungsmethoden eingesetzt, um große Mengen von unstrukturierten Daten zu organisieren und zu bereinigen, um wertvolle Erken **
Ähnliche Suchbegriffe für Guess-Sonnenbrille-GF5082-52F
-
Guess Sonnenbrille GF0324 52F 56Geschlecht: Frauen Hauptfarbe: Braun Extra: Kein Extra Fassungsfarbe: Braun Gestell material: Plastik Farbe der gläser: Braun Material der gläser: Kunststoff Filter Kategorie: 3 Form: Rund Effekt der Linsen: Farbverlauf Schutz: 100% UVA & UVB Breite der Gläser: 58 Höhe der Gläser: 53 Breite der Brücke: 20 Rahmenbreite: 140 Bügellänge: 145 Federscharnier: Nein Lieferung umfasst: Markenetui Felgenform: Vollrandig55,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie beeinflusst die Verwendung von Suchindizes die Effizienz von Datenbankabfragen in der Informatik und wie werden sie in verschiedenen Anwendungen wie Suchmaschinen, Datenbanken und Big Data-Analysen eingesetzt?
Die Verwendung von Suchindizes verbessert die Effizienz von Datenbankabfragen, da sie es ermöglichen, schnell auf die gespeicherten Daten zuzugreifen, ohne die gesamte Datenbank durchsuchen zu müssen. In Suchmaschinen werden Suchindizes verwendet, um die relevantesten Ergebnisse für eine Suchanfrage zu liefern, indem sie die relevanten Informationen aus dem gesamten Web indexieren. In Datenbanken ermöglichen Suchindizes eine schnelle Suche und Abfrage von Daten, was die Leistung und Effizienz der Datenbank verbessert. In Big Data-Analysen werden Suchindizes verwendet, um große Datenmengen effizient zu durchsuchen und relevante Informationen für die Analyse zu extrahieren. **
-
Wie beeinflusst die Verwendung von Suchindizes die Leistung von Datenbankabfragen in der Informatik und wie werden sie in verschiedenen Anwendungen wie Suchmaschinen, Datenbanken und Big-Data-Analysen eingesetzt?
Die Verwendung von Suchindizes verbessert die Leistung von Datenbankabfragen, indem sie den Zugriff auf die gespeicherten Daten beschleunigen. Sie ermöglichen es, die relevanten Datensätze schneller zu finden und abzurufen, was die Antwortzeiten bei Abfragen verkürzt. In Suchmaschinen werden Suchindizes verwendet, um die Suchergebnisse effizient zu liefern, während sie in Datenbanken die Abfragegeschwindigkeit verbessern. In Big-Data-Analysen werden Suchindizes eingesetzt, um große Datenmengen effizient zu durchsuchen und relevante Informationen zu extrahieren, was die Analyseprozesse beschleunigt. **
-
Wie beeinflusst die Verwendung von Suchindizes die Effizienz von Datenbankabfragen in der Informatik und wie werden sie in verschiedenen Anwendungen wie Suchmaschinen, Datenbanken und Big-Data-Analysen eingesetzt?
Die Verwendung von Suchindizes verbessert die Effizienz von Datenbankabfragen, da sie es ermöglichen, schnell auf relevante Daten zuzugreifen, ohne die gesamte Datenbank durchsuchen zu müssen. In Suchmaschinen werden Suchindizes verwendet, um die Suchergebnisse schnell und genau zu liefern, indem sie relevante Webseiten vorab indizieren. In Datenbanken ermöglichen Suchindizes eine schnellere Abfrageverarbeitung, indem sie den Zugriff auf bestimmte Datensätze beschleunigen. Bei Big-Data-Analysen helfen Suchindizes, große Datenmengen effizient zu durchsuchen und relevante Informationen für die Analyse zu extrahieren. **
-
Wie beeinflusst das Splitten von Daten in der Informatik die Effizienz von Algorithmen und die Verarbeitung großer Datenmengen in verschiedenen Anwendungen wie Datenbanken, maschinellem Lernen und Big Data-Analysen?
Das Splitten von Daten in der Informatik ermöglicht es, große Datenmengen in kleinere Teile aufzuteilen, was die Effizienz von Algorithmen verbessert, da sie nur auf einem Teil der Daten arbeiten müssen. Dies führt zu schnelleren Verarbeitungszeiten und reduziert den Speicherbedarf. In Anwendungen wie Datenbanken ermöglicht das Splitten von Daten die parallele Verarbeitung, was die Leistung verbessert. Im maschinellen Lernen ermöglicht das Splitten von Daten das Training von Modellen auf Teilmengen, was die Skalierbarkeit verbessert. In Big Data-Analysen ermöglicht das Splitten von Daten die gleichzeitige Verarbeitung großer Datenmengen, was die Effizienz und Geschwindigkeit der Analyse erhöht. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.